list_altİçindekilerexpand_more
- 01Text-to-SQL nasıl çalışır?
- 02Schema bilgisi ve tablo keşfi
- 03LLM’in doğal dili SQL’e çevirme adımları
- 04LangChain SQLDatabaseChain ile text-to-sql
- 05Kurulum ve temel kullanım
- 06SQLDatabaseAgent ile dinamik çok adımlı sorgular
- 07LlamaIndex NLSQLTableQueryEngine
- 08Index oluşturma ve yapılandırma
- 09Karmaşık birleştirme sorgularını yönetme
- 10Spider ve BIRD: text-to-sql benchmark’ları
- 11Spider: çok veritabanlı değerlendirme standardı
- 12BIRD: gerçek dünya gürültülü şemalar
- 13Structured outputs ile SQL doğrulama
- 14RAG + text-to-SQL: büyük şemalarda hibrit yaklaşım
- 15Üretim ortamında dikkat edilmesi gerekenler
- 16SQL injection ve güvenlik sınırları
- 17Schema maruziyet riski
- 18Doğruluk sınırları ve insan denetimi
- 19FAQ
- 20Text-to-SQL ve NL2SQL aynı şey midir?
- 21Text-to-SQL modelleri SQL injection saldırılarına karşı güvenli midir?
- 22LangChain SQLDatabaseChain ile LlamaIndex NLSQLTableQueryEngine arasındaki fark nedir?
- 23Spider ve BIRD benchmark’larında iyi skor alan modeller hangileri?
- 24Text-to-SQL üretimde kullanmak için ne kadar güvenilir?
Eskiden “Geçen ay en çok satan 5 ürünü getir” gibi bir isteği veritabanına yönlendirmek için SQL bilmek şarttı. Text-to-SQL (ya da nl2sql) bu engeli kaldırıyor: doğal dildeki soruyu alıp çalıştırılabilir bir SQL sorgusuna dönüştüren LLM tabanlı bir sistem.
Türkçe SERP’te bu konuda rehber niteliğinde içerik neredeyse yok; yalnızca akademik PDF’ler mevcut. Bu yazıda text-to-sql’in temel mantığını, LangChain ve LlamaIndex entegrasyonlarını, Spider/BIRD benchmark’larını ve üretime taşırken dikkat edilmesi gereken güvenlik konularını ele alıyoruz.
Text-to-SQL nasıl çalışır?
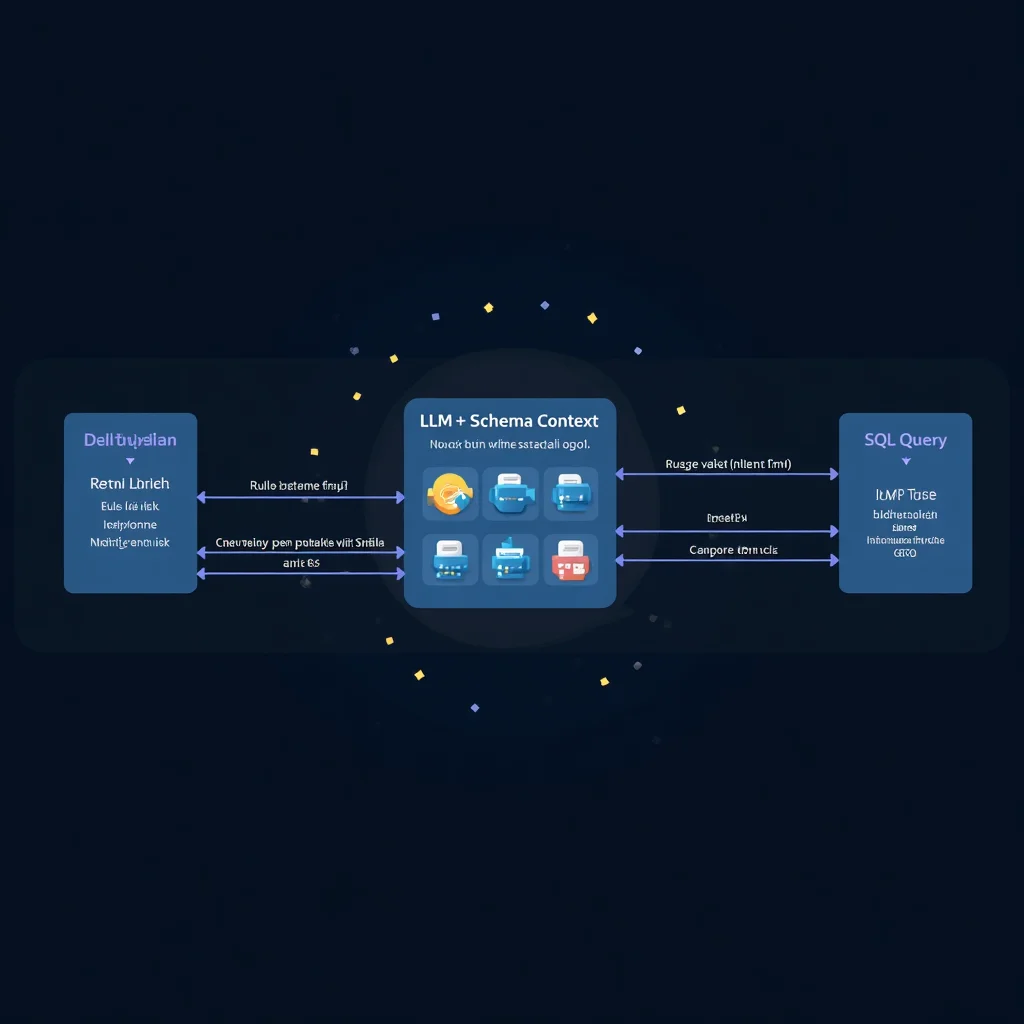
Text-to-SQL’in özünde üç katman var: kullanıcının doğal dil sorusu, veritabanı şeması hakkında LLM’e verilen bağlam ve üretilen SQL sorgusu.
Schema bilgisi ve tablo keşfi
LLM’in doğru SQL yazabilmesi için hangi tablolar ve sütunların var olduğunu bilmesi gerekir. Bu bilgi genellikle CREATE TABLE ifadeleri veya özet bir şema tanımı olarak prompt’a eklenir:
-- Tablolar: products(id, name, category, price), orders(id, product_id, quantity, created_at)
-- Kullanıcı sorusu: Geçen ay en çok satan 5 ürünü getir.
Model bu bağlamı kullanarak hangi tabloları birleştireceğini, hangi sütunları filtreleyeceğini ve nasıl sıralama yapacağını çıkarır. Şema ne kadar iyi açıklanırsa (sütun açıklamaları, örnek değerler), üretilen SQL o kadar doğru olur.
LLM’in doğal dili SQL’e çevirme adımları
- “En çok satan” ifadesinin
SUM(quantity)+ORDER BY DESCanlamına geldiğini anlar. ordersveproductstablolarını ilişkilendirmesi gerektiğini saptar.- “Geçen ay” ifadesini
WHERE created_at BETWEEN ...koşuluna çevirir. - Tam ve çalıştırılabilir bir
SELECTifadesi yazar.
Çıktı doğrudan veritabanında çalıştırılabilir ya da bir doğrulama katmanından geçirildikten sonra uygulanabilir.
LangChain SQLDatabaseChain ile text-to-sql
LangChain, text-to-sql için hazır bileşenler sunar. En temel yaklaşım SQLDatabaseChain’dir.
Kurulum ve temel kullanım
from langchain.sql_database import SQLDatabase
from langchain_experimental.sql import SQLDatabaseChain
from langchain_openai import ChatOpenAI

db = SQLDatabase.from_uri("postgresql://user:pass@localhost/mydb")
llm = ChatOpenAI(model="gpt-4o", temperature=0)

chain = SQLDatabaseChain.from_llm(llm, db, verbose=True)
result = chain.run("Geçen ay en çok satan 5 ürünü listele.")
print(result)SQLDatabaseChain, şema bilgisini otomatik olarak çeker ve LLM’e paslar. verbose=True ile üretilen SQL de dahil olmak üzere ara adımların tamamını görebilirsiniz. Modelin ürettiği sorguyu her zaman gözden geçirin.
SQLDatabaseAgent ile dinamik çok adımlı sorgular
Tek adımlı chain’in yetersiz kaldığı karmaşık senaryolarda create_sql_agent kullanılır. Agent, gerektiğinde şemayı tekrar inceler, birden fazla sorgu dener ve hatadan geri döner:
from langchain_community.agent_toolkits import create_sql_agent

agent = create_sql_agent(
    llm=llm,
    db=db,
    agent_type="openai-tools",
    verbose=True
)
agent.invoke({"input": "Hangi kategoride en yüksek ortalama sipariş değeri var?"})
Agent yaklaşımı daha esnek ama daha pahalıdır; her adımda yeni LLM çağrısı yapılır. Basit sorgular için SQLDatabaseChain tercih edilmeli, çok adımlı analitik için agent kullanılmalıdır.
LlamaIndex NLSQLTableQueryEngine
LlamaIndex, veri bağlantısı odaklı bir çerçevedir ve text-to-sql için farklı bir yaklaşım sunar.
Index oluşturma ve yapılandırma
from llama_index.core import SQLDatabase, Settings
from llama_index.core.query_engine import NLSQLTableQueryEngine
from llama_index.llms.openai import OpenAI
from sqlalchemy import create_engine

engine = create_engine("postgresql://user:pass@localhost/mydb")
sql_database = SQLDatabase(engine, include_tables=["products", "orders"])

Settings.llm = OpenAI(model="gpt-4o")

query_engine = NLSQLTableQueryEngine(
    sql_database=sql_database,
    tables=["products", "orders"]
)

response = query_engine.query("En yüksek geliri olan 3 ürün kategorisi hangileri?")
print(response)NLSQLTableQueryEngine, LangChain’den farklı olarak tablo bazında index oluşturur. Bu, büyük şemalarda hangi tablonun ilgili olduğunu önceden seçmeyi mümkün kılar; her sorguda tüm şemayı göndermenize gerek kalmaz.
Karmaşık birleştirme sorgularını yönetme
Birden fazla tablo gerektiren JOIN sorgularında LlamaIndex, SQLTableRetrieverQueryEngine ile ilgili tabloları önce vektör aramasıyla seçer:
from llama_index.core.objects import (
    SQLTableNodeMapping,
    ObjectIndex,
    SQLTableSchema,
)

table_node_mapping = SQLTableNodeMapping(sql_database)
table_schema_objs = [
    SQLTableSchema(table_name="products", context_str="Ürün kataloğu, fiyat ve stok bilgisi"),
    SQLTableSchema(table_name="orders", context_str="Müşteri siparişleri ve tarih bilgisi"),
]
obj_index = ObjectIndex.from_objects(table_schema_objs, table_node_mapping)

query_engine = SQLTableRetrieverQueryEngine(
    sql_database, obj_index.as_retriever(similarity_top_k=2)
)
Bu yaklaşım, 50+ tablolu şemalarda doğruluk ve maliyet açısından ciddi avantaj sağlar; yalnızca alaka düzeyi yüksek tablolar prompt’a dahil edilir.
Spider ve BIRD: text-to-sql benchmark’ları
Text-to-SQL modellerini karşılaştırmak için iki ana benchmark öne çıkıyor.
Spider: çok veritabanlı değerlendirme standardı
Spider, Yale Üniversitesi tarafından geliştirilen ve 2018’den beri standart haline gelen benchmark’tır. 10.000’den fazla soru, 200 veritabanı ve 138 alan içerir.
| Metrik | Açıklama |
|---|---|
| Exact Match (EM) | Üretilen SQL’in referans SQL ile birebir eşleşmesi |
| Execution Accuracy (EX) | Sorgunun doğru sonuç döndürmesi (farklı yazımda bile) |
Spider’da başarılı modeller:
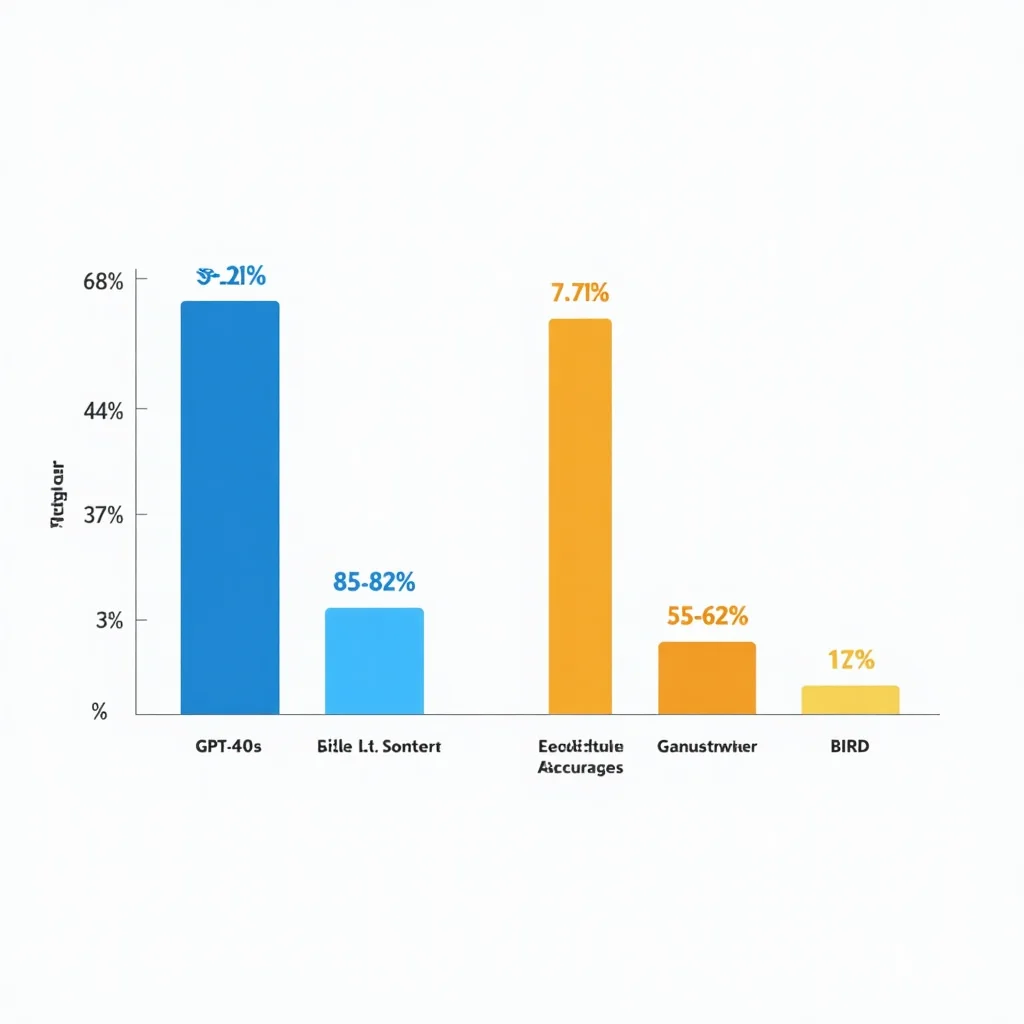
- GPT-4o: EX ~85%
- Claude 3.5 Sonnet: EX ~83%
- DeepSeek Coder: EX ~82%
Spider’ın güçlü yanı: veritabanları eğitim setinde yok, yani modeller genelleme yapmak zorunda. Zayıf yanı: sentetik sorular gerçek dünya karmaşıklığını tam yansıtmıyor.
BIRD: gerçek dünya gürültülü şemalar
BIRD (BIg Reasoning and understanding of Databases), 2023’te yayınlanmış ve Spider’ın eksikliklerini kapatan bir benchmark’tır. 12.751 soru, 95 veritabanı ve gerçek kaynaklardan alınmış gürültülü şema isimlendirmeleri içerir.
BIRD’ü Spider’dan ayıran kritik fark: değer bağımlı sorular. “Müdür” yerine veritabanında “mgr” yazan bir sütunu modelin çıkarması beklenir. Bu, üretim ortamını çok daha iyi simüle eder.
BIRD’de dikkat çeken bulgular:
- GPT-4 bile BIRD’de %60’ın altında kalabiliyor (Spider’daki ~85%‘e kıyasla)
- Schema linking (hangi sütunun hangi soruya karşılık geldiğini bulmak) en zor adım
- Dış bilgi gerektiren sorularda tüm modeller ciddi düşüş yaşıyor
Bu iki benchmark birlikte kullanıldığında, hem genelleme hem de gerçek dünya dayanıklılığı test edilmiş olur.
Structured outputs ile SQL doğrulama
LLM her zaman geçerli SQL üretmez. Sözdizimi hataları, var olmayan sütun isimleri veya yanlış tablo birleştirmeleri olabilir. Structured outputs burada bir doğrulama katmanı olarak devreye girer.
Pydantic ile SQL çıktısını doğrulayan bir yapı:
from pydantic import BaseModel, field_validator
import sqlparse

class SQLOutput(BaseModel):
    query: str
    explanation: str

    @field_validator("query")
    @classmethod
    def validate_sql(cls, v):
        parsed = sqlparse.parse(v)
        if not parsed or parsed[0].get_type() not in ("SELECT",):
            raise ValueError("Yalnızca SELECT sorgularına izin verilir")
        return v
Bu yapı iki şeyi garantiler: LLM belirli bir formatta yanıt vermek zorunda kalır ve üretilen sorgunun en azından SELECT tipinde olduğu doğrulanır. Daha ileri doğrulama için sqlglot kütüphanesi şema-aware parse ederek var olmayan sütunları yakalayabilir.
RAG + text-to-SQL: büyük şemalarda hibrit yaklaşım
Yüzlerce tablosu olan kurumsal veritabanlarında tüm şemayı prompt’a sığdırmak mümkün değildir. RAG (Retrieval Augmented Generation) ile text-to-sql’i birleştirmek bu sorunu çözer.
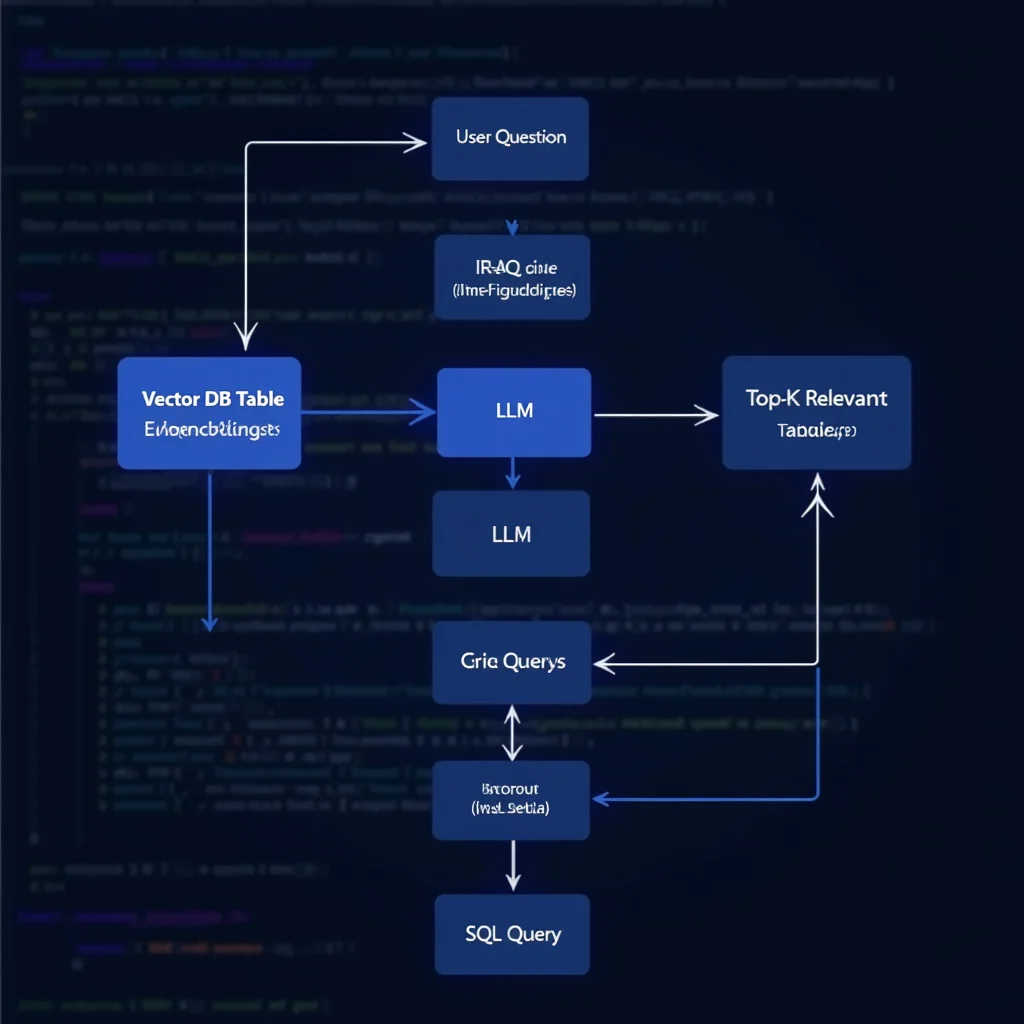
Hibrit yaklaşımın mantığı:
- Her tablo ve sütun açıklaması embedding’e dönüştürülür, vektör veritabanına kaydedilir.
- Kullanıcı sorusu da embedding’e çevrilir, en yakın tablolar vektör aramasıyla bulunur.
- Yalnızca ilgili 5-10 tablo şeması LLM’e gönderilir.
- Model daraltılmış bağlamla çok daha doğru SQL üretir.
from llama_index.core import VectorStoreIndex
from llama_index.core.schema import TextNode

# Her tabloyu bir node olarak index'le
table_nodes = [
    TextNode(text=f"Tablo: {t.name}\nSütunlar: {t.columns}\nAçıklama: {t.description}", id_=t.name)
    for t in all_tables
]
index = VectorStoreIndex(table_nodes)

# Sorgu için ilgili tabloları bul
retriever = index.as_retriever(similarity_top_k=5)
relevant_tables = retriever.retrieve(user_question)
Bu yaklaşım, büyük şemalarda doğruluğu önemli ölçüde artırır. Ayrıca function calling ile LLM’e “şemayı araştır, sonra SQL üret” yeteneği de verilebilir; bu çok adımlı yaklaşım özellikle bilinmeyen şemalarda etkilidir.
Üretim ortamında dikkat edilmesi gerekenler
Text-to-sql’i bir prototipten gerçek bir ürüne taşımak ciddi güvenlik ve güvenilirlik gereksinimleri doğurur.
SQL injection ve güvenlik sınırları
LLM’in ürettiği SQL doğrudan çalıştırılmamalıdır. Önce bir allowlist kontrolünden geçirilmeli:
import sqlglot

def is_safe_sql(query: str) -> bool:
    try:
        parsed = sqlglot.parse_one(query)
        # Yalnızca SELECT'e izin ver
        if parsed.key != "select":
            return False
        # Subquery'de DML olup olmadığını kontrol et
        for node in parsed.walk():
            if node.key in ("insert", "update", "delete", "drop", "truncate"):
                return False
        return True
    except Exception:
        return False
Bunun yanı sıra veritabanı kullanıcısını salt-okunur izinle yapılandırmak en güçlü koruma katmanıdır. Uygulama kullanıcısının SELECT dışında hiçbir yetkisi olmamalı.
Schema maruziyet riski
LLM’e şema gönderilmesi, bu şemanın log’larda ve üçüncü taraf API’lerde görünmesi anlamına gelebilir. Müşteri kişisel verisi içeren tablo isimleri ve sütun adları dikkatli filtrelenmeli; hassas tablolar şema prompt’una dahil edilmemelidir.
Doğruluk sınırları ve insan denetimi
En iyi modeller bile karmaşık analitik sorularda hata yapabilir. BIRD benchmark’ında gördüğümüz gibi, gerçek dünya şemalarında doğruluk önemli ölçüde düşer. Üretim sistemlerinde önerilen yaklaşım:
- Üretilen SQL’i kullanıcıya gösterin ve “Bu sorguyu çalıştırayım mı?” onayı isteyin.
- Kritik raporlarda sonucu manuel doğrulayan bir insan adımı ekleyin.
- Sorgu geçmişini loglayın; anormallik tespiti için izleyin.
Text-to-sql’i “tam otomatik SQL motoru” değil, “SQL önerisi üreten yardımcı” olarak konumlandırmak hem doğruluk hem güven açısından daha sürdürülebilir bir yaklaşımdır.
FAQ
Text-to-SQL ve NL2SQL aynı şey midir?
Evet, bu iki terim birbirinin yerine kullanılır. NL2SQL “Natural Language to SQL” kısaltmasıdır. Text-to-SQL daha geniş bir çerçevede kullanılır ve zaman zaman konuşma dili (conversational SQL) sistemlerini de kapsar; özünde aynı tekniği tanımlar.
Text-to-SQL modelleri SQL injection saldırılarına karşı güvenli midir?
Hayır, ek önlem alınmazsa güvenli değildir. LLM’in ürettiği SQL doğrudan çalıştırıldığında zararlı komutlar içerebilir (örneğin bir subquery aracılığıyla DROP TABLE). Savunma katmanları: salt-okunur veritabanı kullanıcısı, sqlglot/sqlparse ile sorgu doğrulama ve DML ifadelerini engelleyen allowlist.
LangChain SQLDatabaseChain ile LlamaIndex NLSQLTableQueryEngine arasındaki fark nedir?
LangChain, chain tabanlı bir yaklaşım sunar ve agent desteğiyle çok adımlı sorgulama yapabilir. LlamaIndex ise tablo bazında indexleme yaparak büyük şemalarda daha verimli tablo seçimi sağlar ve RAG entegrasyonuna daha doğal bir şekilde açılır. İkisi de aynı LLM’leri kullanabilir; tercih projenizin mimarisine bağlıdır.
Spider ve BIRD benchmark’larında iyi skor alan modeller hangileri?
Spider’da GPT-4o (~85% EX), Claude 3.5 Sonnet (~83% EX) ve DeepSeek Coder (~82% EX) öne çıkar. BIRD daha zorlu olduğundan skorlar düşer; GPT-4o BIRD’de yaklaşık %60 EX seviyesinde kalır. Fine-tuned özel modeller (örneğin Defog SQLCoder) belirli şemalarda bu değerlerin üzerine çıkabilir.
Text-to-SQL üretimde kullanmak için ne kadar güvenilir?
Basit, tek tablolu sorgularda üretim için oldukça güvenilir (%90+). Karmaşık JOIN’ler, agregasyon ve veri kalitesi sorunları içeren gerçek dünya şemalarında doğruluk düşer. En iyi pratik: üretilen SQL’i kullanıcıya gösterin, onay alın ve salt-okunur izinlerle çalıştırın. Kritik iş kararları için insan doğrulaması her zaman eklenmeli.